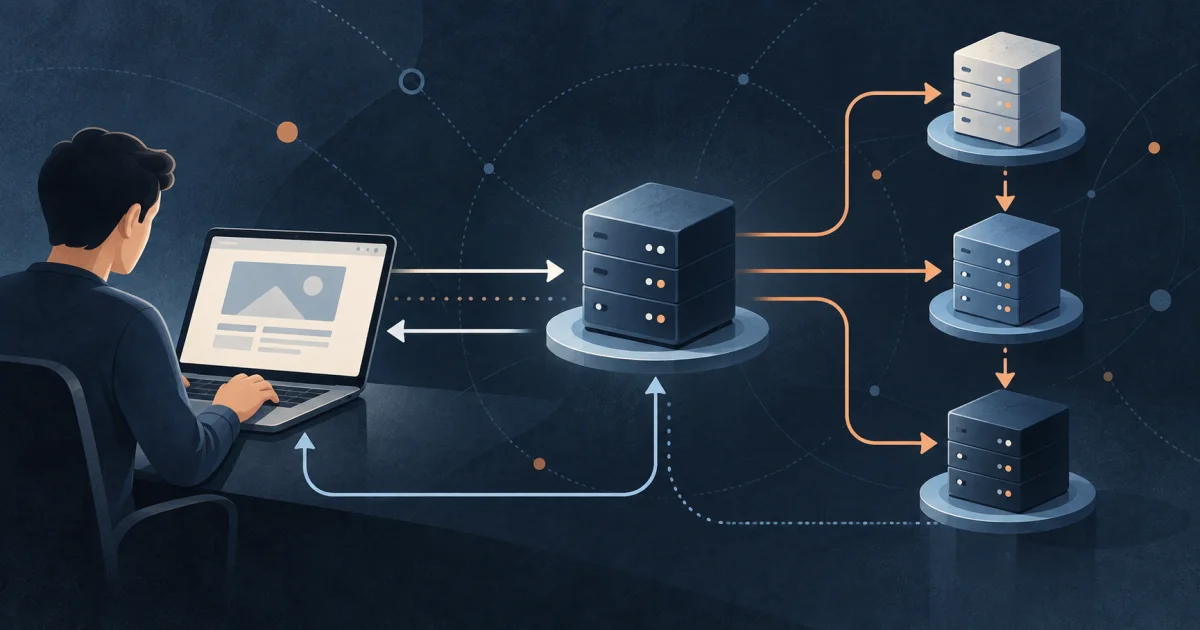
Cómo funciona DNS determina a qué dirección debe dirigirse tu dispositivo cuando escribes un dominio como poderoculto.com. Antes de que el navegador pueda pedir una página, una imagen o un archivo, necesita convertir ese nombre legible en datos que la red pueda usar: normalmente una dirección IP, aunque también puede recibir otras instrucciones.
Esa consulta suele durar milisegundos y casi nunca llega a los mismos servidores en cada visita. Si la respuesta está guardada en una caché, termina cerca de ti. Si no está, un resolvedor debe recorrer una jerarquía pública hasta encontrar quién tiene autoridad sobre ese dominio. No es una guía telefónica única: es una base de datos repartida entre organizaciones y copias sincronizadas.
Cómo funciona DNS antes de cargar una página
El DNS, siglas de Domain Name System, asocia nombres con registros. Un registro A puede devolver una dirección IPv4; uno AAAA, una IPv6; un MX indica dónde se recibe el correo; un CNAME apunta a otro nombre. El navegador no obtiene de ahí la página web ni su contenido. Solo consigue una pista para iniciar la conexión correcta. En ese sentido, cómo funciona DNS depende del tipo de dato solicitado, no solo de una conversión de nombre a IP.
Por eso el viaje completo de una URL tiene más pasos: tras resolver el nombre, el navegador negocia la conexión, solicita recursos y compone la pantalla. El DNS llega primero porque sin una dirección o un destino alternativo, no sabe a qué servidor preguntar.
La separación tiene una ventaja práctica. Una empresa puede cambiar de servidor, repartir tráfico entre varias máquinas o mover una aplicación sin obligar a sus usuarios a memorizar nuevas direcciones numéricas. Cambia sus registros y deja que la actualización se propague según sus reglas de caché.
Cómo funciona DNS cuando no hay una respuesta guardada
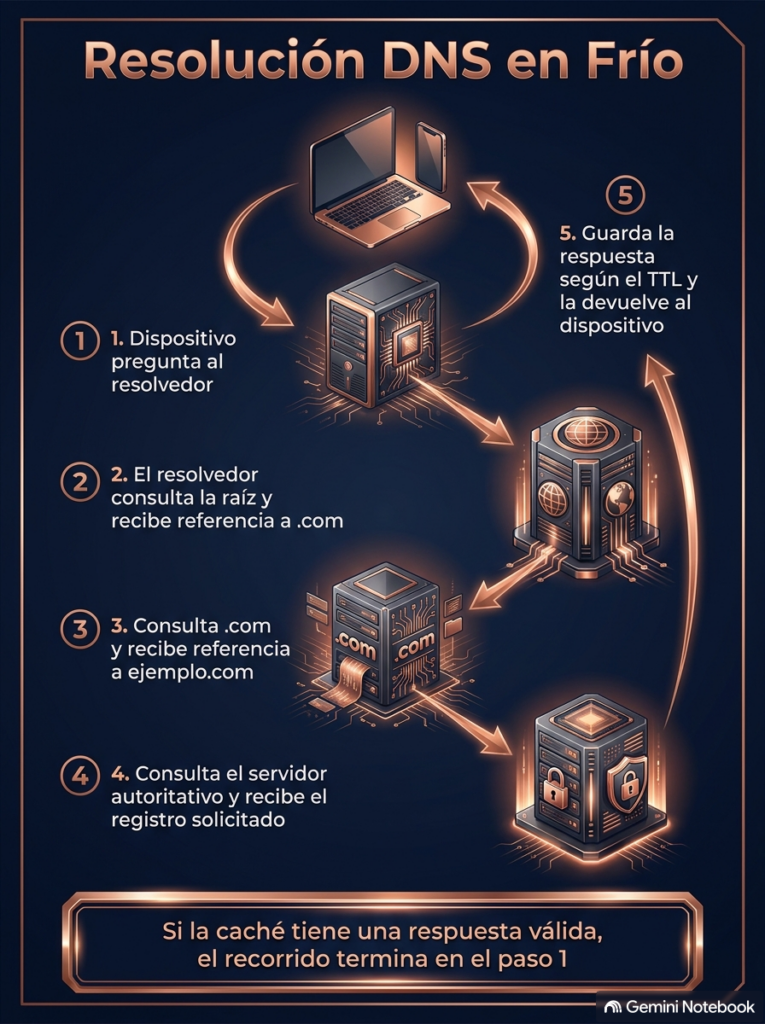
En un caso habitual, el dispositivo entrega la pregunta a un resolvedor recursivo: puede ser el del operador de Internet, el de una red corporativa o un servicio elegido por el usuario. El resolvedor mira antes en su caché. Si aún conserva una respuesta válida, la devuelve sin salir a recorrer Internet.
Cuando la respuesta no está almacenada, empieza una búsqueda por delegaciones. Para resolver www.ejemplo.com, el resolvedor consulta primero la zona raíz. La raíz no le entrega normalmente la IP final; le dice qué servidores conocen .com. Esos servidores de dominio de nivel superior remiten a los servidores autoritativos de ejemplo.com. Solo estos últimos publican la respuesta definitiva para esa zona: por ejemplo, qué registro corresponde a www.
La especificación fundacional del IETF describe precisamente esa división: el espacio de nombres forma un árbol, los servidores autoritativos gestionan zonas y los resolvedores siguen referencias o guardan respuestas. La palabra «recursivo» puede confundir. El ordenador del lector no suele visitar raíz, TLD y autoridad uno por uno; pide el resultado a su resolvedor y este hace el trabajo intermedio.
Los servidores raíz tampoco son un centro de mando de cada búsqueda. Publican la zona raíz, que orienta hacia los dominios de nivel superior. ICANN explica que las identidades de servidores raíz se sirven mediante más de 1.500 instancias distribuidas. Esa redundancia permite que una consulta encuentre una instancia cercana y que el sistema siga funcionando cuando una ruta o una máquina falla. Ahí se ve cómo funciona DNS como servicio distribuido, no como un único ordenador que contenga todos los dominios.
La caché evita repetir el mismo viaje
Cada registro DNS puede llevar un TTL, siglas de time to live. Es el tiempo durante el cual un resolvedor puede conservarlo antes de volver a consultar. Un TTL de 300 segundos permite reutilizar una respuesta durante cinco minutos; otro mucho mayor reduce más consultas, pero retrasa los cambios si el administrador necesita trasladar un servicio.
La caché no es un detalle de rendimiento. Evita que millones de usuarios pregunten por el mismo dominio a cada nivel de la jerarquía. También explica algunos errores aparentemente caprichosos: una web puede haber cambiado de dirección y seguir mostrando el destino anterior en un resolvedor hasta que venza el TTL. Saber cómo funciona DNS ayuda a situar ese desfase en una caché concreta, no en una avería global. En cada consulta, cómo funciona DNS también depende de si el TTL aún permite reutilizar una respuesta. Distintas cachés se actualizan en momentos distintos.
Este diseño reparte una tarea enorme sin crear una libreta central que todos deban descargar. La infraestructura de Internet depende de muchas piezas coordinadas: redes, cables, enrutadores, centros de datos y servicios de nombres. El DNS convierte una etiqueta humana en una ruta posible dentro de ese conjunto.
Autoridad no significa propiedad de Internet
Un servidor autoritativo es fiable para una zona concreta porque el sistema lo designa como fuente de sus registros, no porque controle los ordenadores a los que apuntan esos registros. Una empresa puede delegar su DNS en un proveedor especializado y alojar su web en otra compañía. También puede usar redes de distribución que devuelven direcciones distintas según la ubicación del usuario. Esta parte de cómo funciona DNS separa la autoridad sobre un registro de la propiedad de la infraestructura final. Para quien administra un dominio, cómo funciona DNS condiciona además la velocidad con la que un cambio de registro se vuelve visible.
La diferencia importa al hablar de poder e infraestructura. Quien administra una zona puede dirigir un nombre hacia un destino, pero no posee por ese hecho toda la red, ni todos los datos que circulan, ni los centros de datos donde finalmente se ejecuta una aplicación. DNS, alojamiento, tránsito y contenido son capas relacionadas, pero distintas.
Tampoco todos los fallos de una página son fallos de DNS. Si el resolvedor obtiene una IP correcta y el servidor está caído, el nombre ha funcionado. Si un dominio expira o un registro se configura mal, la página puede dejar de ser localizable aunque sus servidores sigan encendidos. Distinguir ambas situaciones evita buscar el problema en la capa equivocada.
DNSSEC comprueba el origen; DoH protege el trayecto
El DNS clásico nació cuando las consultas se asumían públicas. DNSSEC añade firmas criptográficas a ciertos datos para que un resolvedor que valida pueda comprobar que la respuesta procede de la zona adecuada y no fue alterada durante el camino. La RFC 4033 es explícita sobre su límite: aporta autenticación de origen e integridad, no confidencialidad y tampoco detiene un ataque de denegación de servicio.
Esa distinción desmonta una confusión frecuente. DNSSEC puede ayudar a detectar una respuesta falsificada, pero no oculta qué dominio se ha consultado a quien observa una consulta DNS tradicional. Para cifrar el transporte existen protocolos como DNS sobre HTTPS, o DoH. La RFC 8484 define cómo enviar consultas y respuestas DNS dentro de intercambios HTTPS. Comprender cómo funciona DNS exige mantener separados ese cifrado y la validación de la respuesta. También muestra que cómo funciona DNS en el transporte no decide por sí mismo quién conserva los datos de la consulta.
DoH dificulta que un observador situado entre el dispositivo y el resolvedor lea la consulta como texto DNS convencional. No elimina por sí solo la huella digital: el proveedor del resolvedor puede recibir las consultas y las capas de IP y HTTP pueden aportar información correlacionable. Seguridad, privacidad y disponibilidad son tres propiedades diferentes; mejorar una no concede automáticamente las otras dos.
La infraestructura invisible que decide a dónde miras
Cuando escribes una dirección, el DNS suele resolver un problema pequeño antes de que aparezca nada en pantalla: averiguar quién puede responder por ese nombre y qué dato vigente debe devolver. Su fuerza no está en un servidor secreto, sino en un acuerdo técnico distribuido entre delegaciones, operadores y cachés.
Entender cómo funciona DNS también sirve para reconocer sus límites. Un nombre correcto no garantiza que una web sea segura, que el servidor responda o que la consulta sea privada. Cada promesa pertenece a una capa distinta de la red. Esa separación es menos espectacular que una historia de control centralizado, pero explica por qué Internet puede coordinarse a escala mundial sin que una sola máquina conozca todas las direcciones.
Deja una respuesta