Qué pasa al escribir una URL parece sencillo: introduces una dirección, pulsas Intro y aparece una página. En realidad, ese gesto activa una cadena de decisiones entre el navegador, el sistema operativo, servidores de nombres, redes, sistemas de seguridad y el servidor que aloja el contenido. Todo puede ocurrir en una fracción de segundo, pero no sucede en un único lugar ni lo controla una sola empresa.
Seguir ese recorrido permite entender por qué algunas webs cargan al instante, otras muestran avisos de seguridad y otras fallan aunque Internet siga funcionando. Recibir los datos de una página no es lo mismo que convertirlos en lo que vemos.
Resumen rápido: URL → caché y DNS → conexión → TLS si se usa HTTPS → petición HTTP → procesamiento del servidor → respuesta → descarga de recursos → construcción y renderizado de la página.
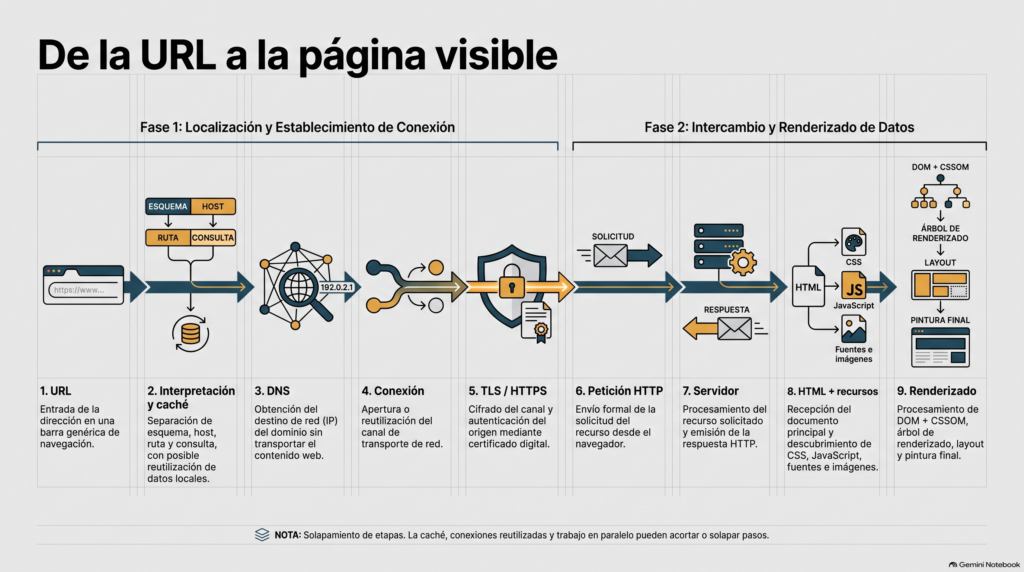
Esta secuencia resume qué pasa al escribir una URL, pero no siempre se ejecuta de forma estrictamente lineal: el navegador puede reutilizar datos, conexiones y recursos, o realizar varias tareas en paralelo.
1. Qué pasa al escribir una URL: primero se interpreta
El primer paso de qué pasa al escribir una URL ocurre antes de enviar nada por la red. La barra del navegador debe decidir si lo introducido es una dirección, una búsqueda o una orden interna. Si reconoce una URL, separa sus componentes.
En https://ejemplo.com/articulo?tema=red, https es el esquema; ejemplo.com, el nombre del host; /articulo, la ruta; y tema=red, una consulta. Puede haber además un puerto, un fragmento o credenciales, aunque estas últimas ya no son habituales en direcciones públicas.
El esquema importa. Una dirección HTTPS pide una comunicación autenticada y cifrada. La ruta y la consulta indican el recurso deseado dentro de ese origen, pero no son instrucciones para encontrar físicamente una máquina. Primero hace falta traducir el nombre legible a una dirección utilizable por la red.
En esta primera fase de qué pasa al escribir una URL, todavía no se ha descargado la página: se ha definido qué recurso se quiere solicitar y bajo qué reglas.
El navegador también consulta políticas locales, extensiones, historial y cachés. Quizá ya tenga una respuesta reciente, una conexión reutilizable o una copia válida del recurso. Por eso el proceso real no siempre recorre todos los pasos desde cero y en el mismo orden.
2. Caché y DNS encuentran un destino
Para explicar qué pasa al escribir una URL, suele decirse que DNS es la agenda de Internet. La comparación sirve si recordamos que no es una libreta central. El sistema de nombres de dominio está distribuido y puede responder desde varias capas de caché.
El navegador y el sistema operativo comprueban primero si ya conocen la dirección IP del dominio. Si no, consultan un resolvedor DNS, que puede pertenecer al proveedor de acceso, a una organización o a un servicio elegido por el usuario. Ese resolvedor busca o reutiliza la respuesta correspondiente y devuelve registros que permiten llegar al servicio.
DNS forma parte de qué pasa al escribir una URL, pero no es el canal que transporta después el contenido de la página. Su función en este recorrido es ayudar a localizar el destino.
Chromium explica la resolución DNS como el paso necesario para determinar qué servidor es responsable de entregar el sitio. Con DNS sobre HTTPS, la consulta viaja por un canal cifrado. Eso protege el contenido de la consulta frente a observadores del trayecto, pero no convierte al proveedor DNS en invisible ni garantiza por sí solo que la web sea legítima.
Una dirección IP tampoco siempre identifica un servidor físico único. Puede conducir a una red de distribución de contenido, un balanceador o un punto cercano que elegirá después entre varios servidores. Dos personas que escriban la misma URL pueden recibir direcciones distintas según su ubicación, la carga o la salud de la red.
Este paso encaja dentro del mapa más amplio de cómo funciona Internet: DNS localiza servicios, mientras routers y operadores transportan los paquetes. Confundir ambos papeles hace pensar que DNS lleva la página hasta el usuario, cuando en realidad ayuda a señalar un destino.
3. Se abre una conexión y HTTPS comprueba la identidad
Con un destino disponible, qué pasa al escribir una URL entra en la fase de conexión. Durante mucho tiempo, la secuencia habitual fue abrir una conexión TCP y después negociar TLS para HTTPS. HTTP/2 suele funcionar sobre esa combinación. HTTP/3 utiliza QUIC sobre UDP e integra de otra forma transporte y seguridad, de modo que no todas las cargas modernas repiten exactamente el mismo saludo.
La especificación HTTP define HTTPS por la protección de la comunicación y la autoridad del origen, no por estar atado para siempre a TCP. El navegador y el servidor negocian versiones y parámetros compatibles. Si ya existe una conexión segura reutilizable, parte de este trabajo puede evitarse.
Durante TLS, el servidor presenta un certificado. El navegador comprueba, entre otras cosas, que corresponda al dominio, que esté dentro de su periodo de validez y que encadene con una autoridad de confianza. Después ambas partes establecen claves de sesión.
El candado no afirma que el propietario sea honrado ni que el contenido sea verdadero. Indica que el navegador ha establecido una conexión cifrada con el origen autenticado por el certificado. Una web fraudulenta también puede usar HTTPS. La seguridad del canal y la fiabilidad de quien publica son preguntas diferentes.
Una VPN añade otro túnel entre el dispositivo y su servidor, pero no sustituye HTTPS. Cambia quién observa una parte de la ruta y desde qué dirección pública sale el tráfico; el navegador aún necesita autenticar el sitio final.
4. HTTP pide el documento y el servidor responde
Ahora llega la petición. En el caso más común, el navegador solicita el documento con un método como GET e incluye el destino y cabeceras que describen capacidades, formatos aceptados, idioma o estado de caché. Puede añadir cookies asociadas al dominio, siempre dentro de las reglas de seguridad y privacidad aplicables.
HTTP es una familia de protocolos de petición y respuesta. Al estudiar qué pasa al escribir una URL, esto evita una imagen engañosa: el navegador no descarga automáticamente “la web completa”. Pide un recurso y recibe una representación, a menudo HTML, junto con cabeceras y un código de estado.
El servidor puede devolver 200 con contenido, redirigir con un código 3xx, indicar que el recurso no existe con 404 o comunicar un error interno con 500. Una redirección inicia otra navegación hacia la nueva dirección. Varias redirecciones consecutivas aumentan el tiempo y, si forman un bucle, impiden llegar al documento.
Entre el navegador y la aplicación pueden intervenir una CDN, un proxy inverso, un cortafuegos, un balanceador y varias cachés. La respuesta quizá ya esté guardada cerca del usuario o tenga que generarse consultando bases de datos y otros servicios. Por eso un dominio puede resolver correctamente y aceptar conexiones, pero tardar en entregar el primer byte. En esta etapa de qué pasa al escribir una URL, la demora puede estar en el servidor aunque la red y el navegador hayan completado correctamente su trabajo previo.
Para entender mejor esa capa, consulta cómo funciona una CDN y cómo decide si sirve una copia guardada o pide el contenido al servidor de origen.
En trayectos internacionales, parte de los paquetes puede cruzar los cables submarinos. No existe una ruta universal para cada web: los operadores eligen caminos según interconexiones, congestión y averías, y la respuesta no tiene por qué regresar por la misma secuencia exacta.
5. El HTML se convierte en una página visible
Recibir HTML todavía no completa qué pasa al escribir una URL. El navegador comienza a analizar los bytes y construye el DOM, una representación en forma de árbol de los elementos del documento. No siempre espera a que termine toda la descarga: puede procesar fragmentos y descubrir nuevos recursos mientras llegan.
Las hojas de estilo se analizan para formar el CSSOM. El navegador combina la estructura del documento y sus estilos en un árbol de renderizado que contiene lo necesario para mostrar los elementos visibles. Después calcula el tamaño y la posición de cada caja en la fase de layout y finalmente pinta los píxeles.
La guía de MDN sobre cómo funcionan los navegadores separa precisamente el análisis, la construcción de DOM y CSSOM, el estilo, el layout y la pintura. La ruta crítica de renderizado ayuda a explicar por qué ciertos recursos retrasan la primera imagen útil.
El HTML suele descubrir CSS, JavaScript, fuentes, imágenes y vídeos alojados en el mismo origen o en dominios externos. Cada recurso puede exigir otra resolución DNS, conexión y petición, aunque las conexiones persistentes, la multiplexación y las cachés reducen trabajo. El JavaScript también puede modificar el DOM, pedir datos adicionales o retrasar el análisis según cómo se cargue.
Así, qué pasa al escribir una URL continúa después de recibir el documento principal: la página visible suele depender de una constelación de peticiones secundarias.
Por eso “la página ha cargado” no designa un único instante. Puede aparecer texto antes que una imagen, ser visible antes de responder a los clics o seguir solicitando datos mucho después del primer renderizado.
6. Qué puede acelerar, desviar o romper la carga
La explicación lineal de qué pasa al escribir una URL es útil, pero la ejecución real se solapa. El navegador puede anticipar una navegación, precargar DNS, abrir conexiones, reutilizar contenido local o solicitar varios recursos al mismo tiempo. Una service worker incluso puede interceptar peticiones y ofrecer una experiencia sin conexión.
Los mensajes de error permiten acotar la capa que ha fallado:
| Señal visible | Qué ha ocurrido | Dónde mirar primero |
|---|---|---|
| Error DNS | No se obtuvo un destino válido para el dominio | Caché y resolución DNS |
| Aviso de certificado | No pudo establecerse la confianza esperada | Dominio, fecha y cadena del certificado |
| Tiempo de espera | Algún tramo no respondió a tiempo | Ruta, intermediarios o servidor |
404 Not Found | El servidor respondió, pero no encontró el recurso | URL, redirecciones o aplicación |
| Página visible pero lenta | El documento llegó, pero quedan recursos o trabajo local | Archivos, JavaScript y renderizado |
La lentitud tampoco prueba por sí sola que “Internet vaya mal”. Puede deberse a latencia física, resolución DNS, negociación, redirecciones, procesamiento del servidor, archivos pesados, JavaScript costoso o trabajo de renderizado en el dispositivo. Las herramientas de desarrollo del navegador separan muchos de esos tiempos y permiten observar peticiones, tamaños, caché y orden de ejecución.
La velocidad esconde una cadena de confianza
La respuesta completa a qué pasa al escribir una URL incluye una cadena de confianza. Confiamos en que el nombre apunte al destino correcto, el certificado represente al dominio, las rutas transporten los paquetes, el servidor entregue el recurso esperado y el navegador ejecute código sin romper sus límites de seguridad.
Esa cadena no implica un centro único. También distribuye el poder entre navegador, sistema operativo, proveedor DNS, operadoras, autoridades certificadoras, CDN, alojamiento y propietario del sitio. Cada capa resuelve un problema, conserva datos distintos y puede introducir bloqueo, vigilancia o dependencia.
Comprender esas relaciones permite localizar mejor qué parte funciona, quién interviene y qué protección ofrece realmente cada símbolo.
De una dirección legible a una página visible
En resumen, qué pasa al escribir una URL no es un viaje único de A a B. El navegador interpreta la dirección, busca información reutilizable, resuelve el dominio, establece una conexión segura, envía una petición HTTP, recibe respuestas y transforma código y recursos en una composición visible.
Algunos pasos desaparecen gracias a la caché; otros ocurren en paralelo; otros cambian con HTTP/3 o con la arquitectura del sitio. Pero la lógica permanece: localizar, autenticar, pedir, recibir e interpretar.
Deja una respuesta